 10 Tháng mười, 2026
Thống kê suy diễn giúp bạn biến những dữ liệu thu thập được từ một nhóm người khảo sát thành cơ sở để đưa ra nhận định về tổng thể nghiên cứu. Vậy thống kê suy diễn là gì, gồm những phương pháp nào và ví dụ thực tế ra sao? Cùng VietGuru tìm hiểu nhé!
1. Thống kê suy diễn là gì?
Trong nghiên cứu khoa học, không phải lúc nào chúng ta cũng có đủ thời gian và nguồn lực để khảo sát toàn bộ đối tượng. Thống kê suy diễn giúp giải quyết vấn đề này bằng cách sử dụng dữ liệu từ một mẫu để đưa ra nhận định về tổng thể, từ đó hỗ trợ kiểm định giả thuyết và đưa ra kết luận có cơ sở khoa học.
1.1. Khái niệm thống kê suy diễn (Inferential Statistics)
Thống kê suy diễn là một nhánh của thống kê sử dụng dữ liệu từ mẫu và lý thuyết xác suất để ước lượng các tham số, kiểm định giả thuyết và rút ra kết luận về tổng thể nghiên cứu.
Khác với thống kê mô tả chỉ tập trung tóm tắt dữ liệu đã thu thập, thống kê suy diễn hướng đến việc khái quát kết quả từ mẫu cho một tổng thể lớn hơn, đồng thời xem xét mức độ không chắc chắn của các kết luận.
Ví dụ: Một doanh nghiệp muốn đánh giá mức độ hài lòng của 20.000 khách hàng nhưng không đủ nguồn lực khảo sát tất cả mọi người. Doanh nghiệp tiến hành khảo sát 500 khách hàng, sau đó phân tích điểm hài lòng trung bình và khoảng tin cậy để ước lượng mức độ hài lòng của toàn bộ khách hàng.
Trong ví dụ này, 500 khách hàng là mẫu khảo sát, còn 20.000 khách hàng là tổng thể nghiên cứu. Việc sử dụng dữ liệu của mẫu để đưa ra nhận định về toàn bộ khách hàng chính là thống kê suy diễn. Tuy nhiên, kết quả chỉ đáng tin cậy khi mẫu được lựa chọn phù hợp, dữ liệu được thu thập đúng cách và các giả định thống kê cần thiết được đáp ứng.
1.2. Mục đích của thống kê suy diễn
Thống kê suy diễn giúp khai thác dữ liệu mẫu để giải quyết các câu hỏi nghiên cứu và đưa ra nhận định có cơ sở. Những mục đích chính của thống kê suy diễn gồm:
- Ước lượng tham số tổng thể: Sử dụng dữ liệu mẫu để ước tính giá trị trung bình, tỷ lệ hoặc mức độ biến động của tổng thể.
- Kiểm định giả thuyết: Đánh giá bằng chứng thống kê nhằm xác định dữ liệu có ủng hộ giả thuyết nghiên cứu hay không.
- Phân tích mối quan hệ giữa các biến: Xác định mức độ liên hệ giữa các yếu tố thông qua những phương pháp như tương quan và hồi quy.
- Hỗ trợ ra quyết định: Cung cấp cơ sở định lượng để lựa chọn phương án trong nghiên cứu khoa học, kinh doanh, giáo dục và nhiều lĩnh vực khác.
Ví dụ: Khi nghiên cứu các yếu tố ảnh hưởng đến sự hài lòng của khách hàng, nhà nghiên cứu có thể sử dụng SPSS để phân tích dữ liệu khảo sát, kiểm định giả thuyết và đánh giá mối quan hệ giữa chất lượng dịch vụ với sự hài lòng.
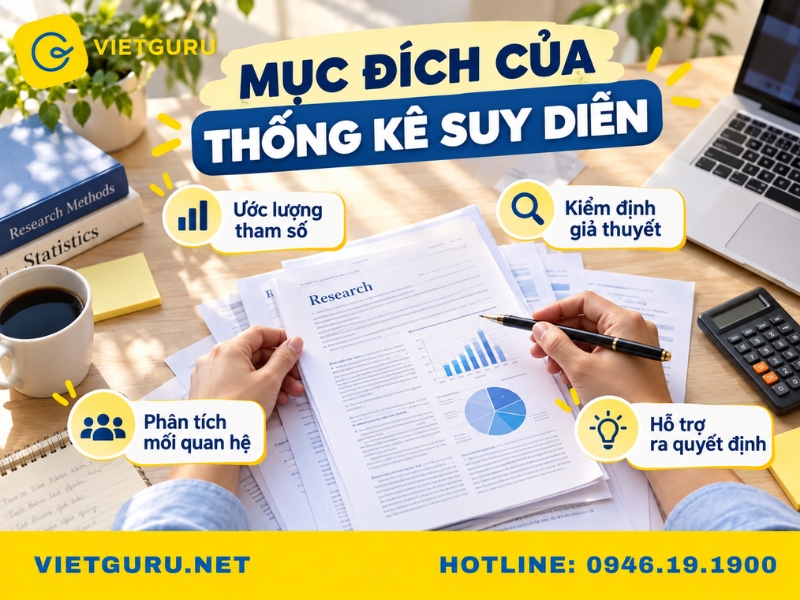
Mục đích của thống kê suy diễn
1.3. Các khái niệm cơ bản
Để hiểu và vận dụng thống kê suy diễn chính xác, bạn cần nắm rõ bốn khái niệm nền tảng sau:
Tổng thể (Population)
- Tổng thể là toàn bộ đối tượng hoặc đơn vị mà nghiên cứu hướng đến. Tổng thể có thể bao gồm con người, doanh nghiệp, sản phẩm hoặc các sự kiện cần phân tích.
- Ví dụ: Toàn bộ sinh viên đang theo học tại một trường đại học là tổng thể khi nghiên cứu mức độ hài lòng của sinh viên.
Mẫu (Sample)
- Mẫu là một phần của tổng thể được lựa chọn để thu thập và phân tích dữ liệu. Một mẫu phù hợp cần phản ánh tương đối chính xác các đặc điểm quan trọng của tổng thể, giúp hạn chế sai lệch khi suy luận.
- Ví dụ: Trong tổng số 10.000 sinh viên, nhà nghiên cứu chọn 500 sinh viên tham gia khảo sát. Khi đó, 500 sinh viên là mẫu nghiên cứu.
Tham số (Parameter)
- Tham số là đại lượng mô tả một đặc điểm của tổng thể, chẳng hạn giá trị trung bình, tỷ lệ hoặc phương sai. Vì thường không thể khảo sát toàn bộ tổng thể, nhà nghiên cứu sử dụng các thống kê tính từ mẫu để ước lượng tham số tương ứng.
- Ví dụ: Mức độ hài lòng trung bình của toàn bộ 10.000 sinh viên là tham số cần ước lượng; điểm hài lòng trung bình của 500 sinh viên được khảo sát là thống kê mẫu.
Sai số chọn mẫu (Sampling Error)
- Sai số chọn mẫu là sự chênh lệch giữa kết quả thống kê tính từ mẫu và giá trị thực của tham số tổng thể do biến động ngẫu nhiên khi chọn mẫu. Sai số này có thể giảm khi thiết kế chọn mẫu phù hợp và tăng kích thước mẫu trong những điều kiện thích hợp. Tuy nhiên, tăng kích thước mẫu không tự động loại bỏ sai lệch do chọn mẫu không đại diện.
- Ví dụ: Điểm hài lòng trung bình của 500 sinh viên là 7,8/10, trong khi giá trị trung bình thực tế của toàn trường là 8,0/10. Chênh lệch 0,2 điểm là sai số chọn mẫu trong tình huống này.
2. Thống kê suy diễn và thống kê mô tả khác nhau thế nào?
Thống kê mô tả và thống kê suy diễn đều được sử dụng để phân tích dữ liệu, nhưng khác nhau về mục đích và cách áp dụng.
| Tiêu chí | Thống kê suy diễn | Thống kê mô tả |
| Mục đích | Ước lượng và đưa ra kết luận về tổng thể từ dữ liệu mẫu. | Tóm tắt và trình bày dữ liệu thu thập được. |
| Phạm vi phân tích | Khái quát từ mẫu sang tổng thể mục tiêu. | Tập trung vào tập dữ liệu hiện có. |
| Phương pháp phổ biến | Ước lượng khoảng tin cậy, kiểm định giả thuyết, hồi quy, ANOVA. | Trung bình, trung vị, mode, phương sai, độ lệch chuẩn, bảng và biểu đồ. |
| Kết quả | Cho biết mức độ bằng chứng thống kê cho các giả thuyết hoặc nhận định về tổng thể. | Cho biết đặc điểm, xu hướng và mức độ phân tán của dữ liệu. |
| Yêu cầu dữ liệu | Cần mẫu và thiết kế nghiên cứu phù hợp; cỡ mẫu phải đủ đáp ứng yêu cầu của phương pháp. | Có thể áp dụng với tập dữ liệu lớn hoặc nhỏ, tùy mục tiêu phân tích. |
Ví dụ: Một trường đại học khảo sát 500 sinh viên về mức độ hài lòng với chất lượng giảng dạy.
- Với thống kê suy diễn: Nhà nghiên cứu sử dụng dữ liệu khảo sát để ước lượng mức độ hài lòng của toàn bộ sinh viên hoặc kiểm định xem mức độ hài lòng có khác biệt giữa các nhóm sinh viên hay không.
- Với thống kê mô tả: Nhà nghiên cứu tính điểm hài lòng trung bình, tỷ lệ sinh viên hài lòng và biểu diễn kết quả bằng biểu đồ.
Thống kê suy diễn và thống kê mô tả khác nhau thế nào?
Trong thực tế, bạn có thể sử dụng cả hai phương pháp thống kê này trên SPSS: bắt đầu bằng thống kê mô tả để kiểm tra dữ liệu, sau đó thực hiện các phép kiểm định hoặc mô hình phù hợp với mục tiêu nghiên cứu.
3. Các phương pháp thống kê suy diễn phổ biến
Thống kê suy diễn sử dụng nhiều phương pháp để phân tích dữ liệu, kiểm tra giả thuyết và rút ra kết luận về tổng thể. Mỗi phương pháp giải quyết một dạng câu hỏi khác nhau: từ ước lượng giá trị trung bình, so sánh các nhóm đến xác định mối liên hệ giữa các biến. Việc lựa chọn đúng phương pháp sẽ giúp kết quả nghiên cứu chính xác, dễ diễn giải và phù hợp với mục tiêu phân tích.
3.1. Ước lượng khoảng tin cậy
Ước lượng khoảng tin cậy là phương pháp xác định một khoảng giá trị có khả năng bao phủ tham số tổng thể dựa trên dữ liệu mẫu, với mức tin cậy được xác định trước, thường là 95% hoặc 99%.
Thay vì chỉ đưa ra một con số ước lượng, phương pháp này cho biết mức độ không chắc chắn của kết quả. Khoảng tin cậy thường có dạng:
Ước lượng điểm ± Biên sai số
Trong đó, biên sai số phụ thuộc vào mức tin cậy, độ biến động của dữ liệu và kích thước mẫu.
Ví dụ: Khảo sát cho thấy điểm hài lòng trung bình của khách hàng là 8,0/10, với khoảng tin cậy 95% từ 7,7 đến 8,3. Khoảng này thể hiện độ bất định trong việc ước lượng điểm trung bình của tổng thể theo phương pháp đã sử dụng.
Ứng dụng: Ước lượng thu nhập trung bình, tỷ lệ khách hàng hài lòng, mức chi tiêu hoặc các chỉ số tổng thể khác.
3.2. Kiểm định giả thuyết
Kiểm định giả thuyết là phương pháp sử dụng dữ liệu mẫu để đánh giá bằng chứng thống kê liên quan đến một nhận định về tổng thể. Đây là công cụ quan trọng để xác định liệu kết quả quan sát được có đủ bằng chứng thống kê để bác bỏ giả thuyết ban đầu hay không.
Quy trình kiểm định gồm:
- Xây dựng giả thuyết: Xác định giả thuyết không H0 và giả thuyết đối H1.
- Chọn mức ý nghĩa: Thường sử dụng α = 0,05.
- Thực hiện kiểm định: Lựa chọn phép kiểm định phù hợp với dữ liệu và mục tiêu nghiên cứu.
- Đọc kết quả: Xem xét giá trị p (p-value) và các chỉ số liên quan.
- Kết luận: Nếu p < 0,05, bác bỏ H0 ở mức ý nghĩa 5%; nếu p ≥ 0,05, chưa đủ bằng chứng để bác bỏ H0.
Một số phép kiểm định quen thuộc gồm:
- Kiểm định Z: Thường dùng để kiểm định trung bình hoặc tỷ lệ trong những điều kiện phù hợp, chẳng hạn khi biết phương sai tổng thể đối với bài toán kiểm định trung bình.
- Kiểm định T (T-test): Dùng để so sánh trung bình, chẳng hạn giữa hai nhóm độc lập hoặc giữa hai lần đo trên cùng đối tượng.
- Kiểm định F: Xuất hiện trong nhiều bài toán, bao gồm so sánh phương sai và kiểm định tổng thể trong phân tích phương sai hoặc hồi quy.
Ví dụ: Một doanh nghiệp muốn kiểm tra xem điểm hài lòng trung bình của khách hàng trước và sau khi cải thiện dịch vụ có thay đổi hay không. Nhà nghiên cứu có thể sử dụng kiểm định T cho mẫu ghép cặp nếu dữ liệu và các giả định phù hợp.
3.3. Phân tích phương sai (ANOVA)
Phân tích phương sai (ANOVA) là phương pháp thống kê suy diễn dùng để kiểm tra xem giá trị trung bình của từ ba nhóm trở lên có khác biệt đáng kể về mặt thống kê hay không. Phương pháp này sử dụng thống kê F để so sánh mức độ biến động giữa các nhóm với mức độ biến động bên trong từng nhóm.
Quy trình phân tích gồm:
- Giả thuyết không H0: Trung bình của các nhóm bằng nhau.
- Giả thuyết đối H1: Có ít nhất một nhóm có giá trị trung bình khác biệt.
- Đánh giá kết quả: Nếu p-value nhỏ hơn mức ý nghĩa đã chọn, thường là 0,05, có đủ bằng chứng thống kê để bác bỏ H0.
Ví dụ: Một nhà nghiên cứu muốn so sánh mức độ hài lòng của khách hàng tại ba chi nhánh khác nhau. ANOVA giúp xác định liệu điểm hài lòng trung bình giữa các chi nhánh có sự khác biệt về mặt thống kê hay không. Nếu kết quả có ý nghĩa, cần thực hiện kiểm định hậu nghiệm để xác định cụ thể những nhóm nào khác biệt.
Ứng dụng: So sánh kết quả học tập giữa các phương pháp giảng dạy, mức độ hài lòng giữa nhiều nhóm khách hàng hoặc hiệu quả của các phương án kinh doanh.
Phân tích phương sai (ANOVA)
3.4. Phân tích tương quan và hồi quy
Phân tích tương quan và hồi quy đều giúp nghiên cứu mối quan hệ giữa các biến, nhưng có mục đích khác nhau. Tương quan đo lường mức độ và chiều hướng liên hệ giữa các biến, trong khi hồi quy mô hình hóa mối quan hệ để giải thích hoặc dự đoán biến kết quả.
- Phân tích tương quan: Đánh giá chiều hướng và mức độ liên hệ giữa hai biến định lượng. Hệ số tương quan Pearson thường nằm trong khoảng từ -1 đến +1. Giá trị gần +1 biểu thị tương quan thuận mạnh, gần -1 biểu thị tương quan nghịch mạnh và gần 0 biểu thị ít hoặc không có tương quan tuyến tính.
- Phân tích hồi quy: Xác định mối quan hệ giữa biến phụ thuộc và một hoặc nhiều biến độc lập. Các dạng phổ biến gồm hồi quy tuyến tính đơn, hồi quy tuyến tính bội và hồi quy logistic.
Ví dụ: Trong nghiên cứu hành vi mua hàng, tương quan có thể giúp đánh giá mối liên hệ giữa chất lượng dịch vụ và sự hài lòng. Hồi quy có thể được sử dụng để xem xét mức độ liên hệ của chất lượng dịch vụ, giá cả và sự thuận tiện với sự hài lòng của khách hàng khi đưa các yếu tố này vào cùng mô hình.
Lưu ý: Tương quan không đồng nghĩa với quan hệ nhân quả. Kết quả hồi quy cũng không tự động chứng minh một yếu tố gây ra sự thay đổi của yếu tố khác.
3.5. Kiểm định Chi bình phương
Kiểm định Chi bình phương (χ²) là phương pháp thống kê suy diễn thường được sử dụng để kiểm tra mối liên hệ giữa hai biến phân loại hoặc đánh giá mức độ phù hợp giữa tần số quan sát và tần số kỳ vọng.
Có hai dạng phổ biến gồm:
- Kiểm định tính độc lập: Xác định liệu hai biến phân loại có mối liên hệ thống kê hay không.
- Kiểm định độ phù hợp: Đánh giá liệu tần số quan sát có khác biệt đáng kể so với phân phối kỳ vọng hay không.
Khi kiểm định tính độc lập, giả thuyết không cho rằng hai biến không có mối liên hệ trong tổng thể. Nếu p-value nhỏ hơn mức ý nghĩa đã chọn, nhà nghiên cứu có đủ bằng chứng thống kê để bác bỏ giả thuyết này. Phép kiểm định cần đáp ứng các điều kiện về lấy mẫu và tần số kỳ vọng; nếu tần số kỳ vọng quá nhỏ, có thể cần cân nhắc phương pháp khác.
Ví dụ: Một nhà nghiên cứu muốn xác định giới tính có liên quan đến lựa chọn hình thức mua sắm trực tuyến hay trực tiếp hay không. Kiểm định Chi bình phương giúp đánh giá mối liên hệ giữa hai biến phân loại này dựa trên dữ liệu khảo sát.
Ứng dụng: Phân tích mối liên hệ giữa giới tính và hành vi mua hàng, nhóm tuổi và lựa chọn sản phẩm hoặc trình độ học vấn và mức độ sử dụng dịch vụ.
5. Lời kết
Nếu bạn đang gặp khó khăn trong quá trình phân tích dữ liệu, lựa chọn kiểm định hoặc đọc kết quả SPSS, VietGuru cung cấp dịch vụ chạy SPSS chuyên nghiệp. Giúp bạn hỗ trợ xử lý dữ liệu, thực hiện các phép kiểm định và giải thích kết quả theo mục tiêu nghiên cứu, từ đó hoàn thiện bài nghiên cứu một cách bài bản và hiệu quả.
Hy vọng bài viết trên đã giúp bạn hiểu rõ thống kê suy diễn là gì, các phương pháp phổ biến và cách ứng dụng trong phân tích dữ liệu. Nắm vững kiến thức này sẽ giúp bạn lựa chọn phương pháp phù hợp, diễn giải kết quả chính xác và đưa ra kết luận có cơ sở khoa học cho bài tiểu luận, khóa luận hoặc luận văn của mình.